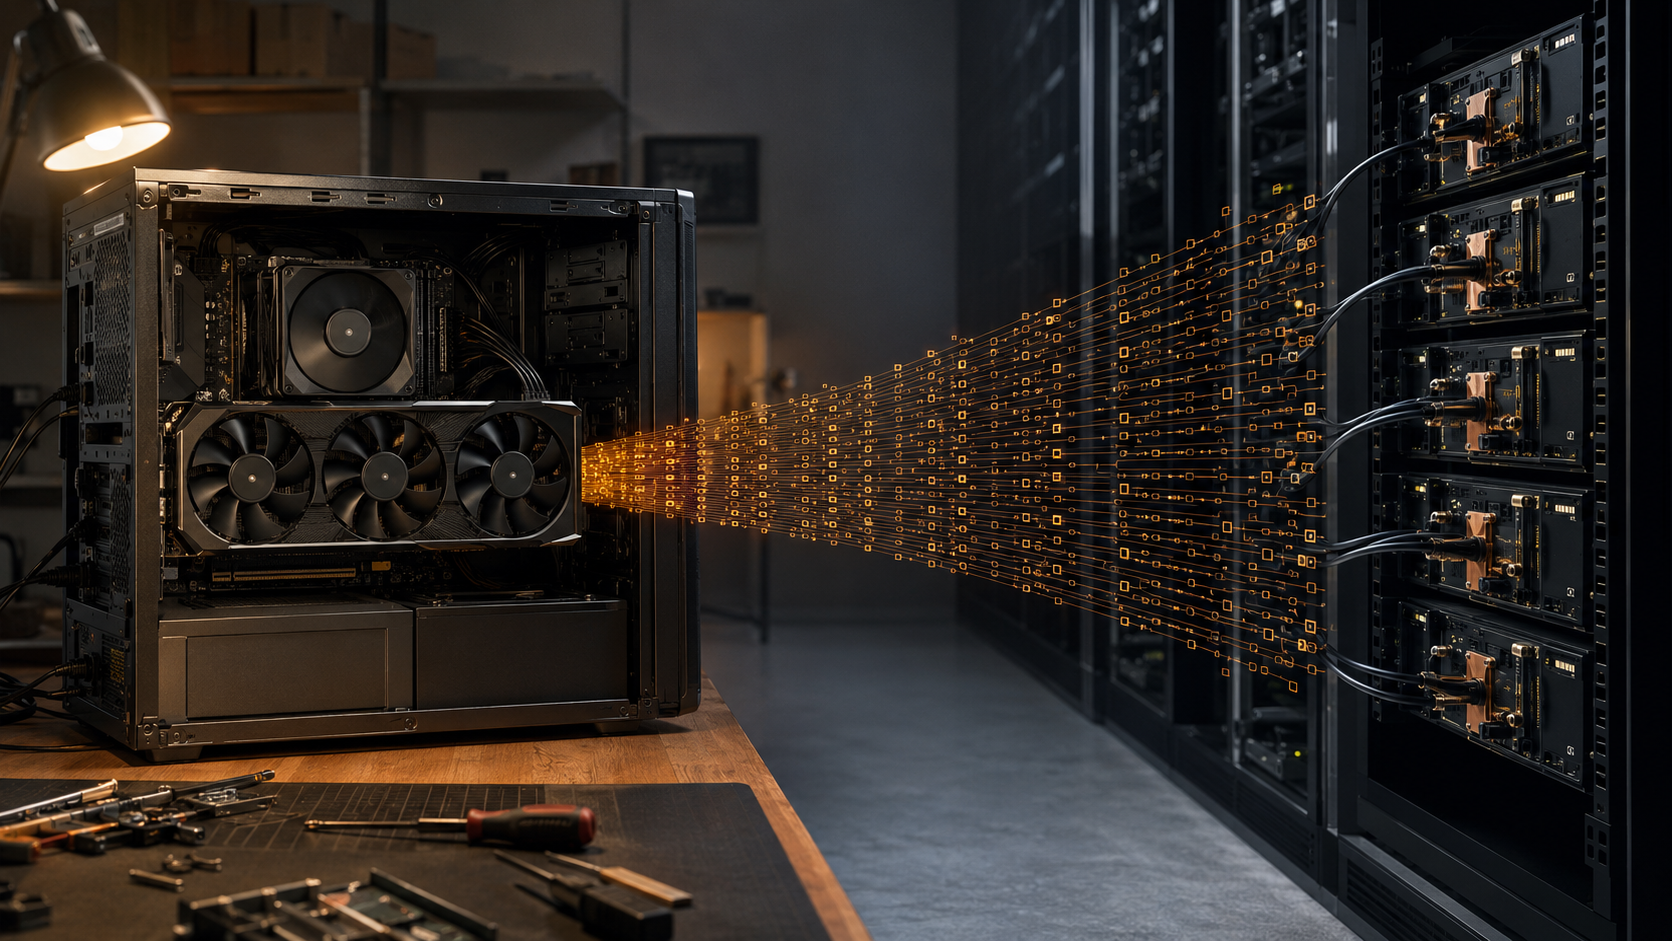
Ещё недавно флагманская игровая видеокарта была понятной покупкой: больше кадров в секунду, лучше свет и тени, выше разрешение. Сегодня ту же плату можно установить в домашнюю рабочую станцию и запустить локальную языковую модель, генератор изображений, распознавание речи или синтез голоса — без обязательной отправки данных в облако.
В этом и состоит ключ к истории NVIDIA. Компания не создала LLM и не единственная выпускает ИИ-ускорители. Но её платформа связала домашнего энтузиаста, университетскую лабораторию, стартап и дата-центр. На одном конце — GeForce RTX в обычном ПК. На другом — стойки из десятков ускорителей. Между ними — общий программный стек, библиотеки и навыки разработчиков.
Почему нейросети пришли на игровые GPU
GPU создавался для того, чтобы одновременно обрабатывать множество похожих операций над пикселями, вершинами и текстурами. Поэтому он стал массово-параллельным процессором с высокой пропускной способностью памяти.
Нейросети оказались задачей того же семейства. Их основа — операции над большими таблицами чисел, прежде всего умножение матриц. GPU не был задуман для LLM, но уже был готовой «фабрикой математики», которую игровой рынок выпускал миллионными тиражами.
Решающим стал не только чип, но и CUDA — программная платформа NVIDIA. Она дала возможность обращаться к GPU из Python и привычных библиотек. Исследователь мог запустить модель на одной карте, затем перенести её на сервер, не переписывая всю математику.
Так появилась сильная обратная связь. Игры финансировали быстрое массовое железо. Исследователи использовали его для глубокого обучения. Успех нейросетей сделал GPU важными далеко за пределами игр, а NVIDIA добавила Tensor Cores и стала строить серверные системы для ИИ.
Домашняя видеокарта уже может быть маленькой лабораторией
Настольная GeForce RTX 5090 имеет 32 ГБ памяти GDDR7. Это не дата-центровый ускоритель и не замена облачному кластеру. Но такой объём уже позволяет запускать многие локальные модели в сжатых форматах и работать с генерацией изображений, речью, видео, компьютерным зрением и небольшими LLM.
Главное ограничение — не размер файла модели на диске, а объём видеопамяти. В неё должны поместиться веса, временные буферы и KV cache — рабочая память диалога, где модель хранит уже обработанный контекст. Чем длиннее контекст, тем больше памяти нужно. Можно частично использовать обычную оперативную память, но тогда GPU начинает ждать данные и генерация резко теряет темп.
Домашняя RTX не поможет обучить следующую frontier-модель. Зато она снижает порог входа: можно изучать архитектуры, запускать приватные инструменты, проверять идеи, делать fine-tuning небольших моделей и создавать собственные проекты без первоначального бюджета на облако. Именно эта доступность сформировала огромное сообщество энтузиастов и практиков.
Почему в дата-центре всё упирается в память
У больших моделей вычисления — лишь половина истории. Для каждого нового токена системе нужно быстро подать к вычислительным блокам веса модели и данные из контекста. Если процессор ждёт память, впечатляющие FLOPS не спасают.
Поэтому важны две вещи: сколько памяти доступно и как быстро она передаёт данные. Игровые карты используют GDDR. Серверные ускорители применяют более дорогую HBM-память, размещённую рядом с вычислительным кристаллом. Она нужна не ради красивой спецификации, а чтобы хранить больше весов и быстрее передавать их в вычисления.
Одной большой карты всё равно недостаточно для крупнейших моделей. Тогда веса и вычисления распределяют по множеству ускорителей. Узким местом становится связь между ними — поэтому дата-центровые системы строятся вокруг быстрых межсоединений, коммутаторов, питания и охлаждения, а не только вокруг отдельных GPU.
Кто конкурирует с NVIDIA
На рынке настольных ПК прямой конкурент NVIDIA — прежде всего AMD. Её Radeon и профессиональные Radeon Pro дают альтернативу для игр, творчества и части локальных ИИ-задач. AMD развивает ROCm — собственный открытый программный стек для GPU-вычислений. Но именно масштаб и зрелость CUDA-экосистемы остаются причиной, по которой многие модели, инструкции и инструменты сначала появляются для NVIDIA.
Intel выпускает дискретные GPU, но сейчас не является сопоставимым игроком в верхнем сегменте настольных карт для локального ИИ. Поэтому честная картина для домашнего пользователя проста: выбор обычно идёт между NVIDIA и AMD, причём NVIDIA чаще предлагает путь с наименьшим количеством технических сюрпризов.
В дата-центрах рынок шире. AMD конкурирует ускорителями Instinct. Google использует собственные TPU, а AWS — Trainium для обучения и Inferentia для запуска моделей. Это не «другие игровые видеокарты», а специализированные решения, в значительной степени привязанные к собственным облакам и их экономике.
Почему NVIDIA так трудно повторить
Преимущество NVIDIA не сводится к одному кристаллу. Компания умеет предложить один непрерывный маршрут: карту для домашнего ПК, профессиональный ускоритель для сервера и стойку для дата-центра. На каждом уровне знакомы CUDA, библиотеки и большое сообщество разработчиков.
При этом сама ИИ-инфраструктура остаётся зависимой от многих компаний: производителей HBM-памяти, передового производства и упаковки чипов, сетевого оборудования, систем охлаждения и облаков. NVIDIA не контролирует всё. Но она оказалась в центре взрыва ИИ, потому что вовремя соединила доступное массовое железо, зрелый софт и масштабирование до индустриального уровня.
Самое важное следствие — не в том, что домашняя видеокарта заменяет облако. Она делает эксперименты с ИИ доступными гораздо большему числу людей. А самые большие модели показывают обратную границу: после определённого масштаба память, сеть и стойка серверов становятся частью самого алгоритма.